
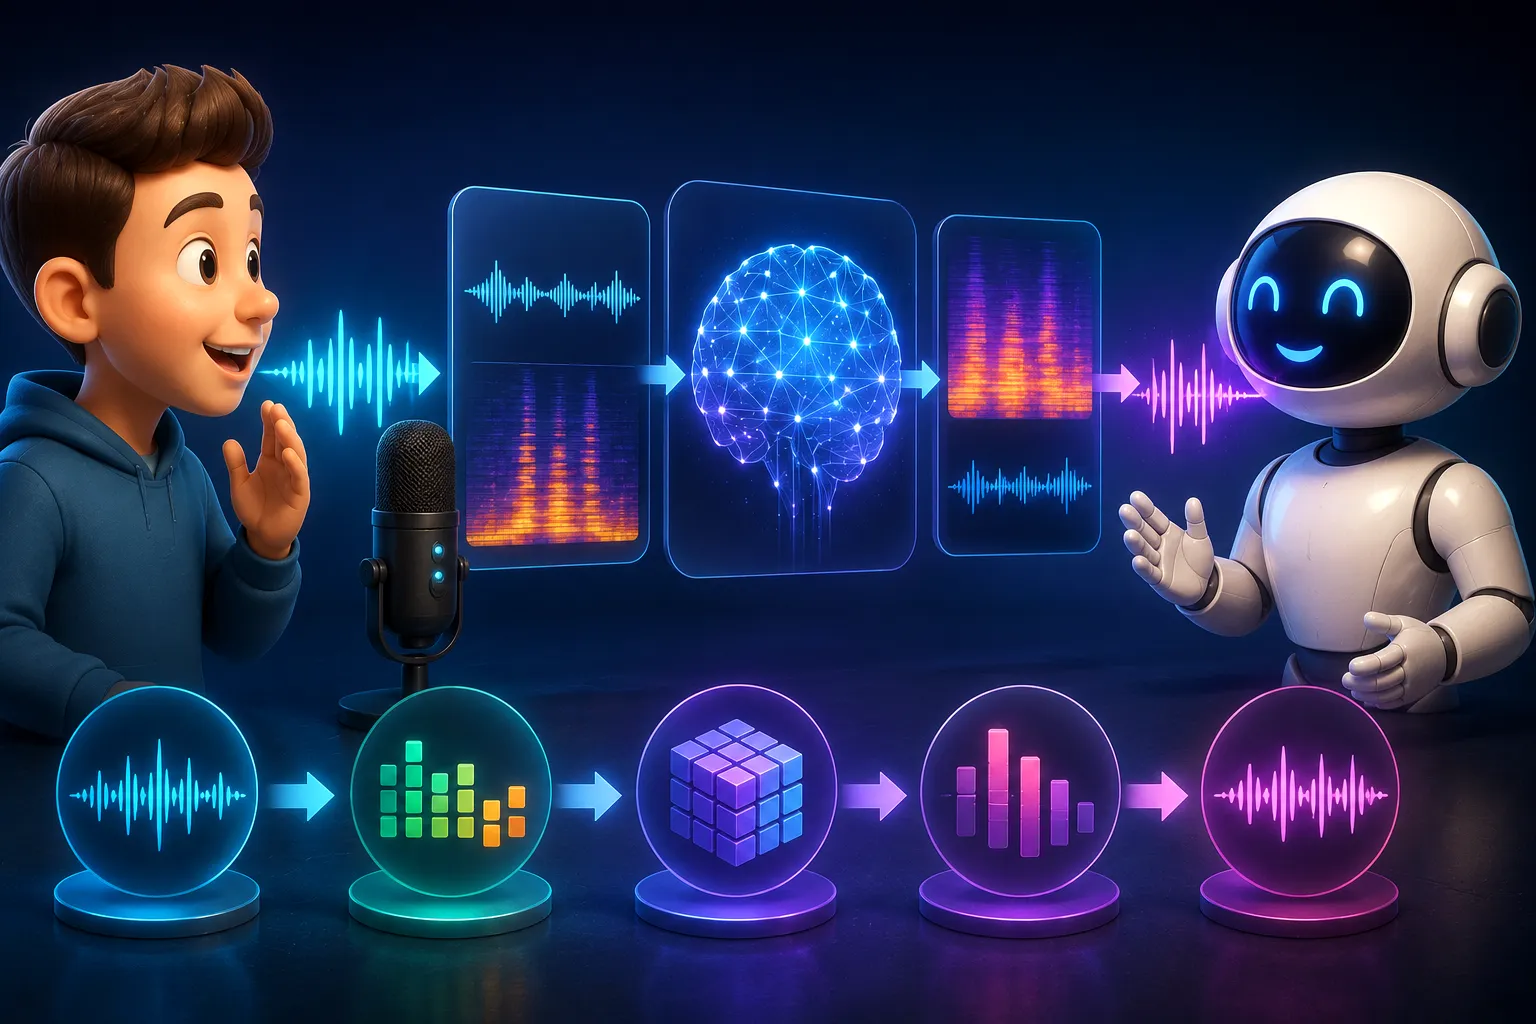
現在,只要對著手機或電腦說話,人工智慧(AI)不但可能聽懂問題,還能立刻用自然的聲音回答。有些AI說話時會停頓、改變語氣,甚至能表現出興奮、疑惑或嚴肅的感覺,聽起來越來越像真人。不過,電腦沒有耳朵、聲帶和嘴巴,它究竟是怎麼做到的?答案就在一種稱為「AI語音模型」的技術。
簡單來說,AI語音模型就是專門學習人類聲音規律的人工智慧。它的主要工作可以分成「聽」和「說」兩個方向。AI把人說話的聲音轉換成文字或可以理解的資料,稱為「語音辨識」;AI把文字和想表達的內容變成聲音,則稱為「語音合成」。如果再加上負責理解問題和產生回答的語言模型,就能形成我們現在看到的AI語音聊天功能。
當人類說話時,聲帶振動會產生聲波,聲波經過空氣傳到麥克風,再被轉換成一連串數字。對電腦來說,人類說出「今天天氣很好」時,它最初並不是直接聽見「今天」、「天氣」和「很好」這些詞,而是接收到一條不斷變化的聲音訊號。
接下來,AI會分析這些聲音。它可以觀察不同時間出現了哪些聲音頻率、聲音持續多久、音高如何變化,以及前後聲音之間有什麼關係。這就像有人把聲音畫成一張特殊的地圖,讓AI從中尋找規律,再判斷這段聲音最可能代表哪些字和句子。
AI聽人說話,也不是簡單地把每一個聲音拿去查字典。它還會參考前後內容來判斷答案。例如,一段錄音受到雜音干擾,有些字聽不清楚,AI可能會根據整句話的意思和常見的語言習慣,推測最可能的內容。換句話說,AI的「耳朵」一邊分析聲音,也一邊利用語言規律進行預測。
那麼,AI又是怎麼學會這些能力的呢?其中一種基本訓練方法,是讓模型接觸大量人類說話的錄音以及相對應的文字。例如,一段錄音中有人說「明天下午可能會下雨」,正確文字也會告訴模型這句話的內容。如果模型第一次辨識成「明天下午可能會下魚」,訓練系統就會計算它錯了多少,再調整模型內部的數學參數。
這個過程會不斷重複。AI一次又一次聽聲音、猜答案、比較正確答案,再根據錯誤調整自己。經過大量訓練後,模型會逐漸學到哪些聲音通常代表哪些發音、哪些詞常常一起出現,以及不同口音、說話速度和環境雜音可能造成哪些變化。
因此,AI並不是把所有聽過的錄音全部背起來。它更像是從大量資料中找出規律,所以即使有人說出一句訓練資料中從未出現過的新句子,模型仍可能正確辨識。
AI學會「聽」之後,還可以學習「說」。這項技術稱為語音合成,也就是把文字或其他資訊轉換成人類可以聽見的聲音。早期的電腦語音常常聽起來一字一字分開,像機器人在念稿。現代AI則會同時考慮發音、速度、停頓、音高和重音,因此說話自然得多。
例如,「你真的來了」這句話,可以有很多不同說法。如果是驚喜,語調可能快速升高;如果是生氣,可能說得緩慢而用力;如果是不敢相信,句子中間可能出現停頓。文字雖然完全相同,但人類可以從聲音中聽出不同的感覺。
現代AI語音模型會從大量真人語音中學習這些差別。因此,它不只需要知道「每個字怎麼念」,還要學習「整句話應該怎麼說」。這也是現在的AI聲音越來越自然的重要原因。
部分新一代語音模型還會把聲音轉換成一連串較小的數字代碼,可以把它們想像成「聲音積木」,技術上常稱為語音Token。模型學習這些聲音積木通常如何排列,再一個接一個產生新的聲音內容。這種概念與文字AI根據前文預測下一個文字Token有些相似,只是處理的對象從文字變成了聲音。
AI也可以學習不同人的聲音特色。每個人的音色、音高、說話速度、停頓方式和發音習慣都有差異。模型可以把這些特色轉換成數學資料,在生成語音時,同時參考「要說什麼」和「應該用什麼聲音來說」。
因此,在取得足夠聲音資料的情況下,AI可以生成具有特定聲音特徵的語音。有些技術甚至只需要較短的聲音範例,就能模仿部分音色和說話特色。不過,這類技術也帶來冒充他人、詐騙和假錄音等問題,因此聲音是否經過本人同意使用,以及如何辨認AI生成內容,也成為重要議題。
當我們與AI進行語音聊天時,背後可能有好幾個系統快速合作。傳統方式是先由語音辨識模型把人說的話變成文字,再交給語言模型理解問題並產生答案,最後由語音生成模型把答案說出來。整個過程就像「聽寫員、思考者和配音員」一起接力工作,而且速度非常快。
新一代AI則開始嘗試更直接地處理聲音資訊。這很重要,因為人類的聲音中包含許多文字無法完整記錄的訊息。例如,一個人嘴上說「我沒事」,但聲音可能很小、說話速度很慢,中間還停頓很久。如果只把語音轉成文字,電腦最後看到的可能只有「我沒事」三個字,原本聲音中的許多線索就消失了。
因此,未來的語音AI可能不只是辨認「你說了什麼」,還能更完整地分析「你是怎麼說的」。這也可能讓人與AI的語音互動變得更加自然。
不過,AI能用高興的語氣說話,不代表它真的感到高興;AI能用悲傷的聲音回答,也不表示它正在難過。語音模型主要是從大量資料中學習人類在不同情況下通常如何說話,再按照學到的規律生成聲音。
簡單來說,AI語音模型之所以能聽又能說,不是因為工程師事先錄好了所有可能出現的句子,而是因為AI從大量人類語音中學會了聲音、文字和說話方式之間的規律。
從只能生硬地念出文字,到現在可以停頓、改變語氣,甚至進行即時對話,AI語音技術已經走了很長一段路。未來,當人們再次聽見電腦自然地說「你好,有什麼可以幫你的嗎?」時,聲音背後其實不是一個躲在機器裡的小人,而是一套經過大量資料訓練、正在高速計算聲音規律的AI系統。只是它說得太自然,有時候確實會讓人忍不住懷疑:電話另一頭是不是有人正在偷偷加班。
總結來說,AI語音模型讓人和電腦的互動更自然,也可能幫助學習與生活。不過,越像真人的科技,越需要清楚標示、保護隱私,並養成查證資訊的習慣。
看更多:AI圖像模型是什麼?生成、訓練原理是什麼?如何作用?怎麼分辨AI圖片?
(完)
[自問自答x互問互答]
看完文章->自問自答->留言紀錄問題與答案->別人看到你的問題可能會覺得這是個好問題->別人看到你的答案可能會覺得還有別的答案->你看到別人的問題與答案時也是類似的反應->互問互答->日復一日->愈學愈多->大家不知不覺就變強了
範例問題:
- 文章提到,AI可以用高興或悲傷的語氣說話,但不代表AI真的有這些感受。你認為「表現出情緒」和「真正感受到情緒」有什麼不同?我們可以用什麼方法判斷?
- AI可以學習並模仿一個人的聲音。你認為這項技術可以帶來哪些幫助,又可能造成哪些問題?如果要訂定使用規則,你會提出哪些規定?
- 如果未來的AI不只能聽懂你說了什麼,還能從語速、音量和停頓判斷你的情緒,你希望AI在什麼情況下使用這項能力?又有哪些情況是你不希望AI分析的?為什麼?
…
你也問問看……
 小傳媒編輯團隊希望幫助小學生提升寫作力。
若你有作文、新詩、讀書心得、電影觀後感、遊記、小日記…… 等希望得到修改與建議,
或有相關作品希望公開發表,歡迎寄到編輯信箱:editor@kidsmedia.com.tw

